Udfordringen ved at ”eftermontere AI”
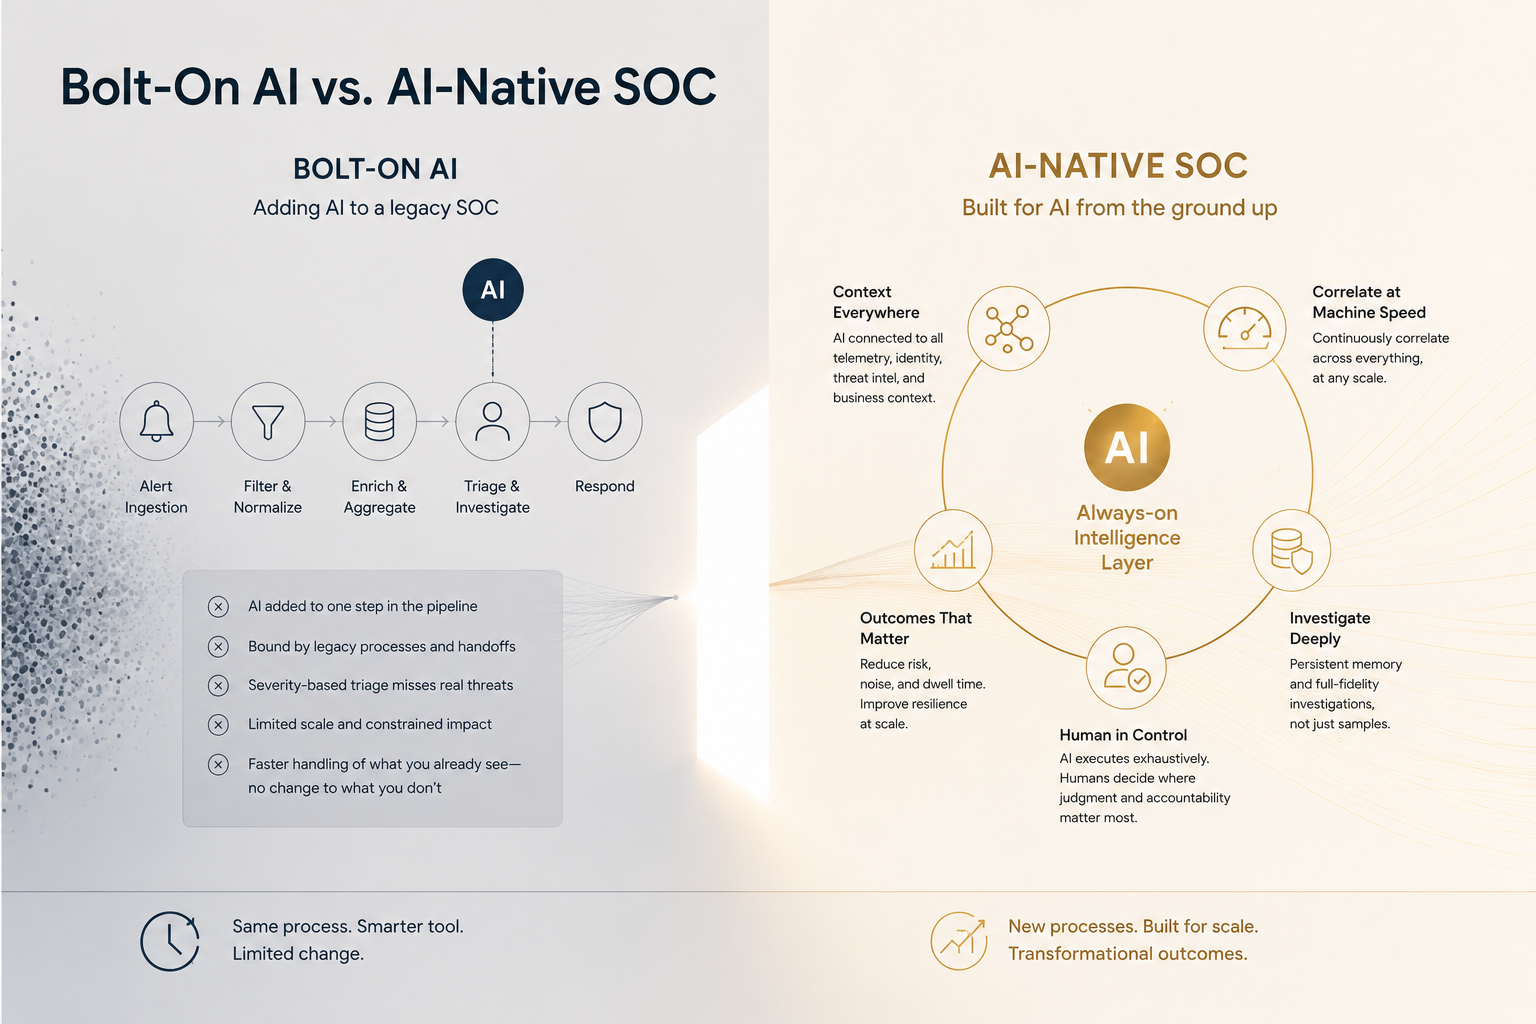
De fleste implementeringer af et såkaldt “AI-SOC” følger det samme mønster: Man bevarer organisationsstrukturen, eskalationsvejene, playbooks og triagering og indsætter derefter en AI-agent i ét enkelt led af processen for at reducere antallet af analytikertimer. Typisk placeres AI-agenten i håndteringen af EDR-alarmer eller phishing, fordi disse arbejdsgange er tilstrækkeligt afgrænsede til, at de kan automatiseres uden at ændre de omkringliggende processer.
Det mønster har vi set før. For ti år siden var det SOAR: Organisationer automatiserede en smal del af arbejdsgangen, mens resten af driften stort set forblev uændret. Værktøjerne ændrede sig, men de underliggende processer gjorde ikke. Resultatet var reelt, men meget begrænset: hurtigere behandling af de alarmer, som sikkerhedsteamet allerede gennemgik, men kun beskedne forbedringer i forhold til de alarmer og hændelser, som teamet overså.
At udskifte SOAR med en stor sprogmodel, en LLM,løser ikke dette problem. Det gentager blot den samme fejl med et mere kompetent værktøj. En SOC-proces fra 2003 kombineret med en LLM er stadig en SOC-proces fra 2003: marginalt hurtigere og billigere, men strukturelt ude af stand til at lukke de huller, der aldrig alene skyldtes hastighed.
En ny virkelighedkræver en ny driftsmodel
Traditionelle SOC-processer blev designet omkring to begrænsninger: mennesker kan ikke huske alle detaljer og bliver mindre konsistente under pres, mens maskiner kun kunne udføre præcis de instrukser, de fik.
Moderne AI-systemer ændrer begge antagelser. En model kan fastholde bred efterforskningskontekst, anvende den igen og igen, og arbejde uden træthed på en mængde opgaver, intet menneskeligt team kunne nå at gennemgå i dybden. Det gør ikke AI til en hurtigere udgave af den samme medarbejder. Det gør den til en anden slags medarbejder. At give den medarbejder en nedarvet proces er ikke neutralt – det sætter loftet for systemet ved grænserne af den proces, det arvede.
Det rigtige spørgsmål er derfor ikke: “Hvis vi designede SOC’en fra bunden til en arbejdsstyrke, der kombinerer mennesker med skalerbar maskinel analyse og ræsonnering, hvilke processer ville vi så etablere?”
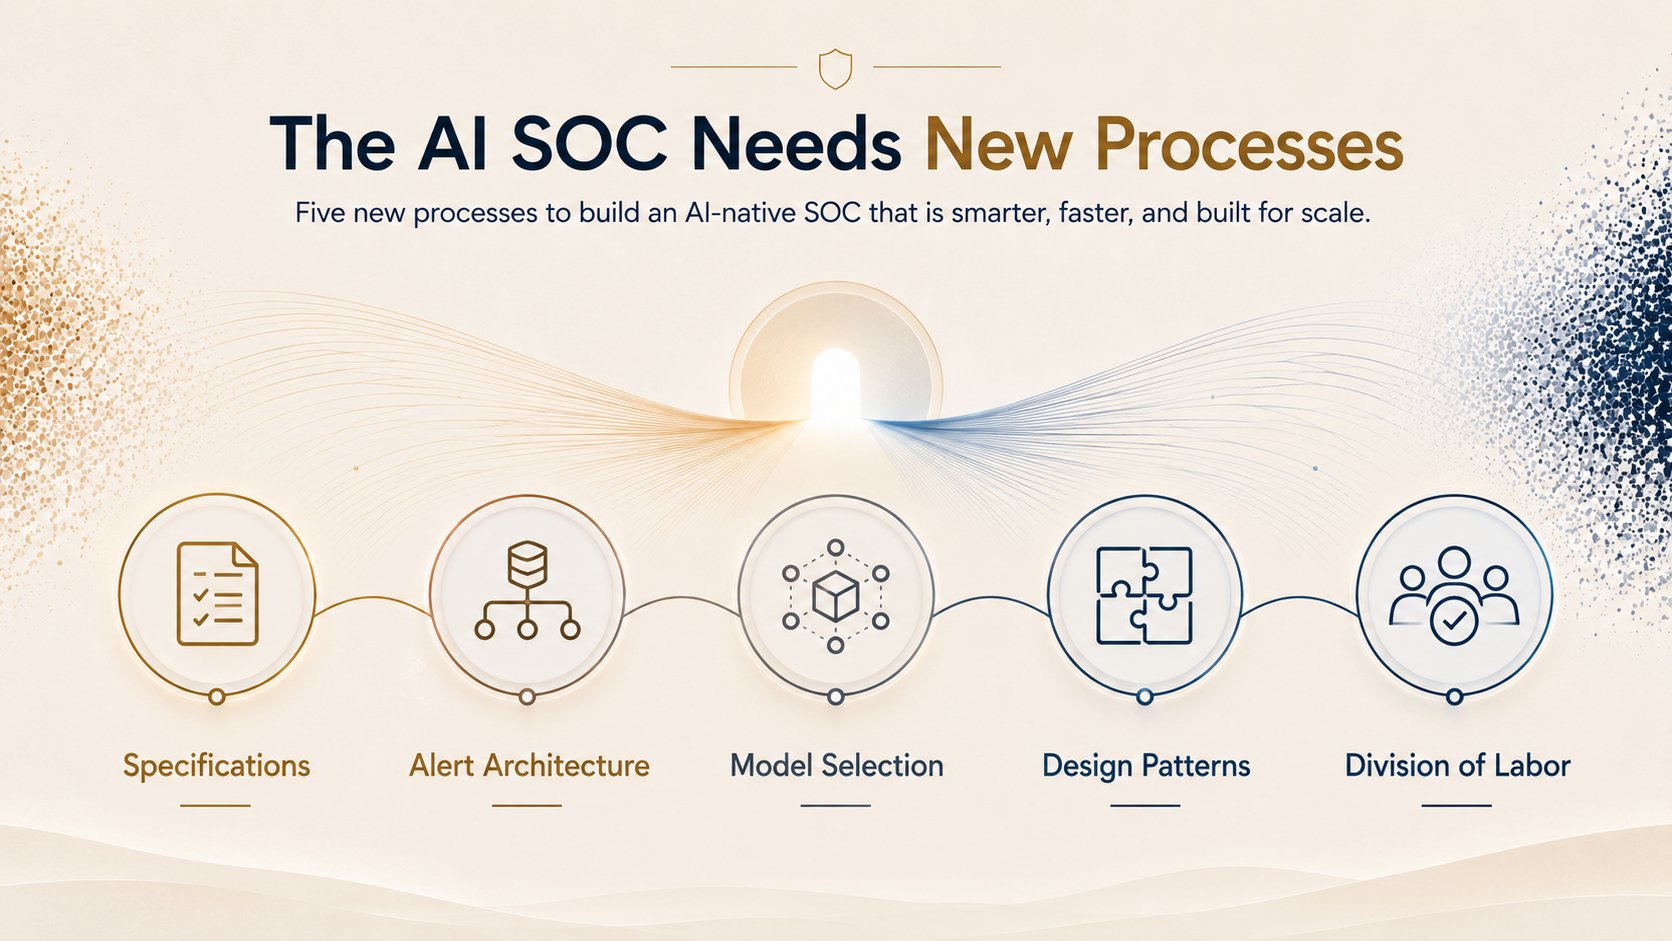
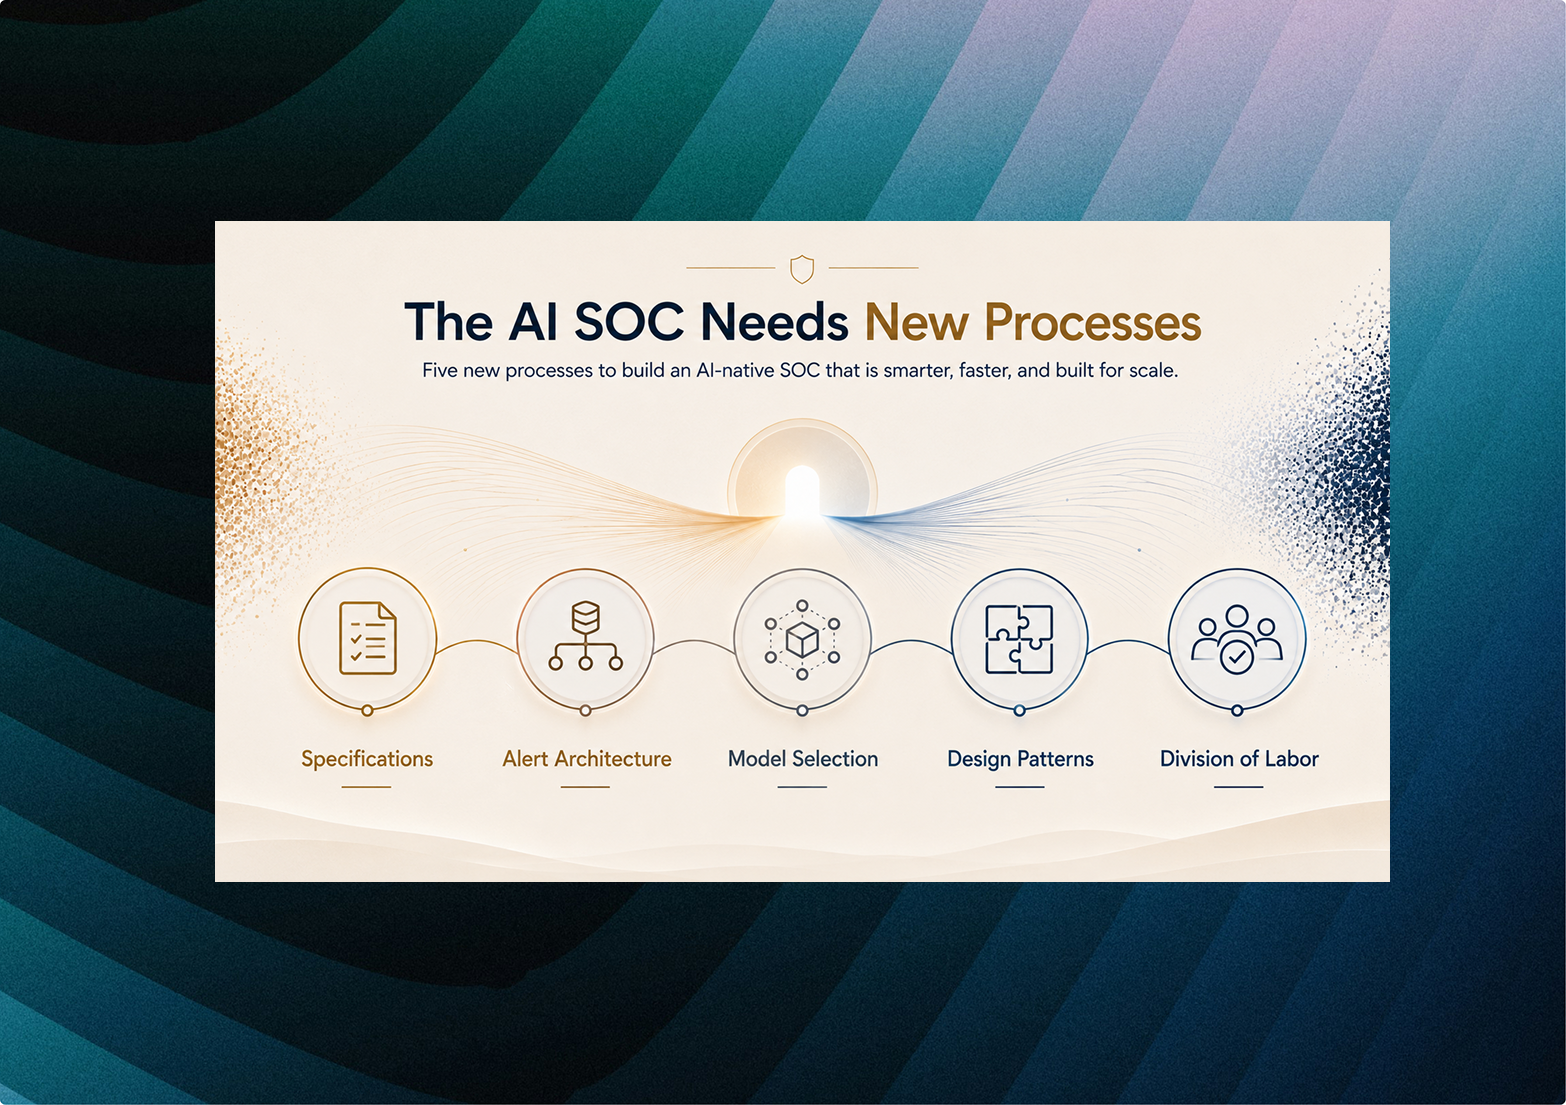
Efter vores vurdering skal svaret findes inden for fem områder:
1. Specifikationer
Playbooks er skrevet til mennesker, der kan glemme procestrin, og til maskiner, der ikke kan ræsonnere. Ingen af disse begrænsninger gælder for en LLM på samme måde, som de gælder for en junioranalytiker eller et traditionelt SOAR-script.
At give en kompetent model en rigid runbook gør den ikke nødvendigvis mere pålidelig. Det begrænser den til den dømmekraft og de scenarier, som forfatteren til runbooken har kunnet forudse.
Det, der reelt hjælper modellen, er styrende rammer: klare grænser, kendte fejlscenarier, forhold den skal være særligt opmærksom på, og kriterier for, hvornår et resultat er tilstrækkeligt godt.
Det er en anden type artefakt – og det kræver en anden proces at udvikle og vedligeholde den.
2. Alarmarkitektur
Fuld dybdegående efterforskning af hver eneste alarm er for dyrt at køre i reel volumen, og forfiltrering efter sværhedsgrad flytter blot risikoen til det niveau, ingen gennemgår.
Reelle sikkerhedshændelser viser sig igen og igen i netop de alarmer, der rutinemæssigt bliver nedprioriteret eller sorteret fra.
Løsningen er ikke at vælge mellem bred alarmbehandling og dybdegående undersøgelser. Løsningen er at gennemføre begge dele – men med forskellig dybde:
• En omkostningseffektiv, indledende analyse af alle alarmer.
• En mere ressourcekrævende og dybdegående undersøgelse af de forhold, som den første analyse identificerer.
3. Modelvalg
Hændelseshåndtering er ikke en kategori, de fleste frontier-modeller benchmarkes eller trænes mod, så "brug bare den bedste model" er ikke en reel strategi. At vide, hvordan man tester og vælger en model specifikt til hændelseshåndtering - og at forskellige opgavelag kan kræve forskellige modeller - er nu en disciplin i sig selv, ikke en teknisk fodnote.
4. Designmønstre
Den måde, modeller kædes sammen og kontrollerer hinandens arbejde på, er mindst lige så vigtig som valget af de enkelte modeller.
Det samme princip, der siger, at kode ikke bør kvalitetssikres alene af den person, der har skrevet den, gælder også for sikkerhedsundersøgelser: Den agent, der opstiller en hypotese, bør ikke være den samme agent, der efterfølgende validerer hypotesen.
Det er en beslutning om proces- og systemdesign - ikke blot en beslutning om modelvalg.
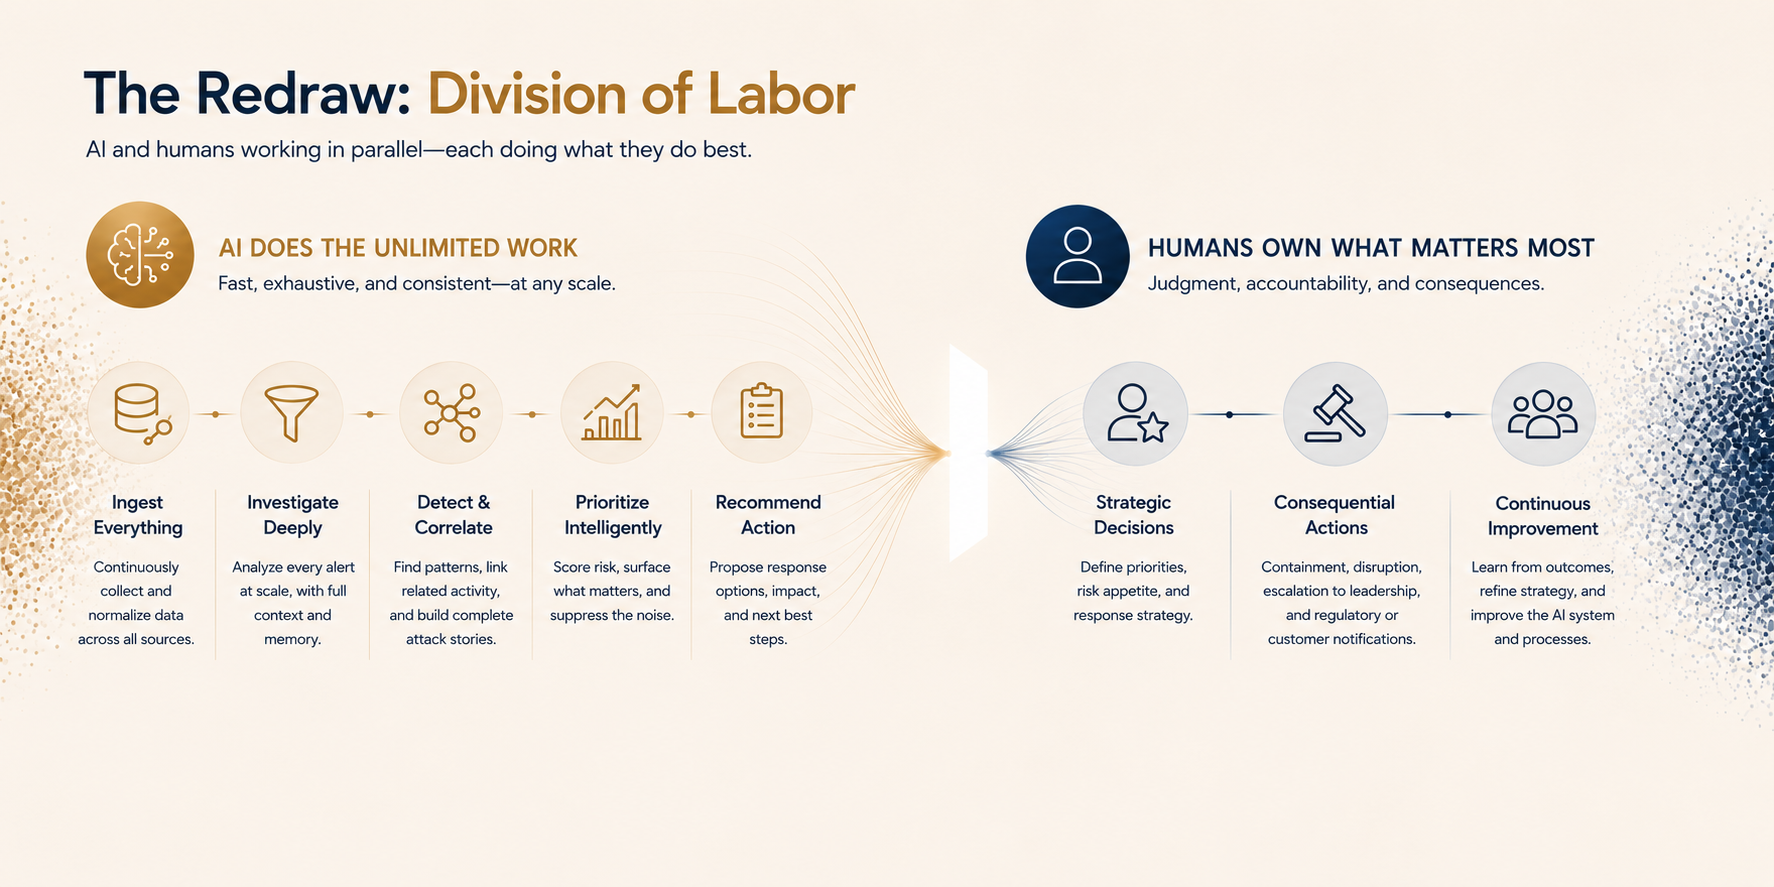
5. Arbejdsdeling
Når AI konsekvent og i stor skala kan udføre gentagne undersøgelsesopgaver, bør SOC’en ikke længere fordele arbejdet ud fra begrænsningerne i menneskelig bemanding og traditionelle vagtstrukturer.
Målet er ikke at efterligne hvert enkelt klik, som en analytiker foretager.
Målet er at definere:
• Det ønskede resultat.
• Den nødvendige evidens.
• De beslutninger, der fortsat kræver ansvarligt og dokumenterbart menneskeligt skøn.
Eksempler på denne arbejdsdeling kan være:
Kompromittering af en identitet:
AI rekonstruerer angrebsforløbet, mens mennesker godkender indgribende handlinger på brugerkonti.
Mistænkelig aktivitet:
AI undersøger og grupperer relaterede alarmer, mens mennesker tilfører forretningsmæssig kontekst og beslutter, hvordan hændelsen skal inddæmmes.
Incident response:
AI anbefaler handlinger og vurderer hændelsens påvirkningsomfang, mens mennesker har ansvaret for beslutninger med væsentlige driftsmæssige, juridiske eller kundemæssige konsekvenser.
Det næste skridt: Processen er Produktet
Fremtidige systemer kan komme til at anvende world models eller andre modelklasser, der i højere grad kan ræsonnere direkte om miljøer, årsagssammenhænge, handlingssekvenser og forventede resultater.
En robust og langsigtet SOC-arkitektur bør derfor være modelagnostisk. Den skal designes omkring kapabiliteter, evidens, kontrolmekanismer og klart placeret ansvar - ikke omkring én bestemt generation af LLM-teknologi.
Den største mulighed i et AI-drevet SOC er ikke at automatisere endnu en analytikeropgave. Det er at gentænke selve operativsystemet for sikkerhedsdriften omkring en arbejdsstyrke, der kombinerer skalerbar maskinel analyse med ansvarligt menneskeligt skøn.
De velkendte byggesten forsvinder ikke nødvendigvis. Normalisering, berigelse og aggregering af alarmer samt eskalation og governance vil fortsat være vigtige.
Det, der ændrer sig, er, hvordan arbejdet:
• Udvælges og prioriteres.
• Dirigeres og undersøges.
• Kontrolleres og kvalitetssikres.
• Overdrages mellem modeller og mennesker.
Organisationer, der blot eftermonterer en LLM på en eksisterende legacy-proces, vil opnå effektiviseringsgevinster.
Organisationer, der gentænker og genopbygger selve processen, kan opnå noget langt mere værdifuldt: bredere undersøgelsesdækning, mere konsekvent og dokumenterbar ræsonneringsamt et SOC, der endelig kan operere i samme skala som de trusler, det står over for.