
Da cybersikkerhedseksperter hos Sovera Security satte sig for at bygge en agentbaseret pipeline, stod én ting hurtigt klart: De sværeste problemer handler ikke rigtig om AI. Zero trust, mindste privilegium, alignment, løbende validering, optimering og omkostningseffektivitet skal komme først. AI kommer efter alt dette.
Disse principper guider vores design af en AI-drevet MDR, der kan fungere sikkert, effektivt og i stor skala.
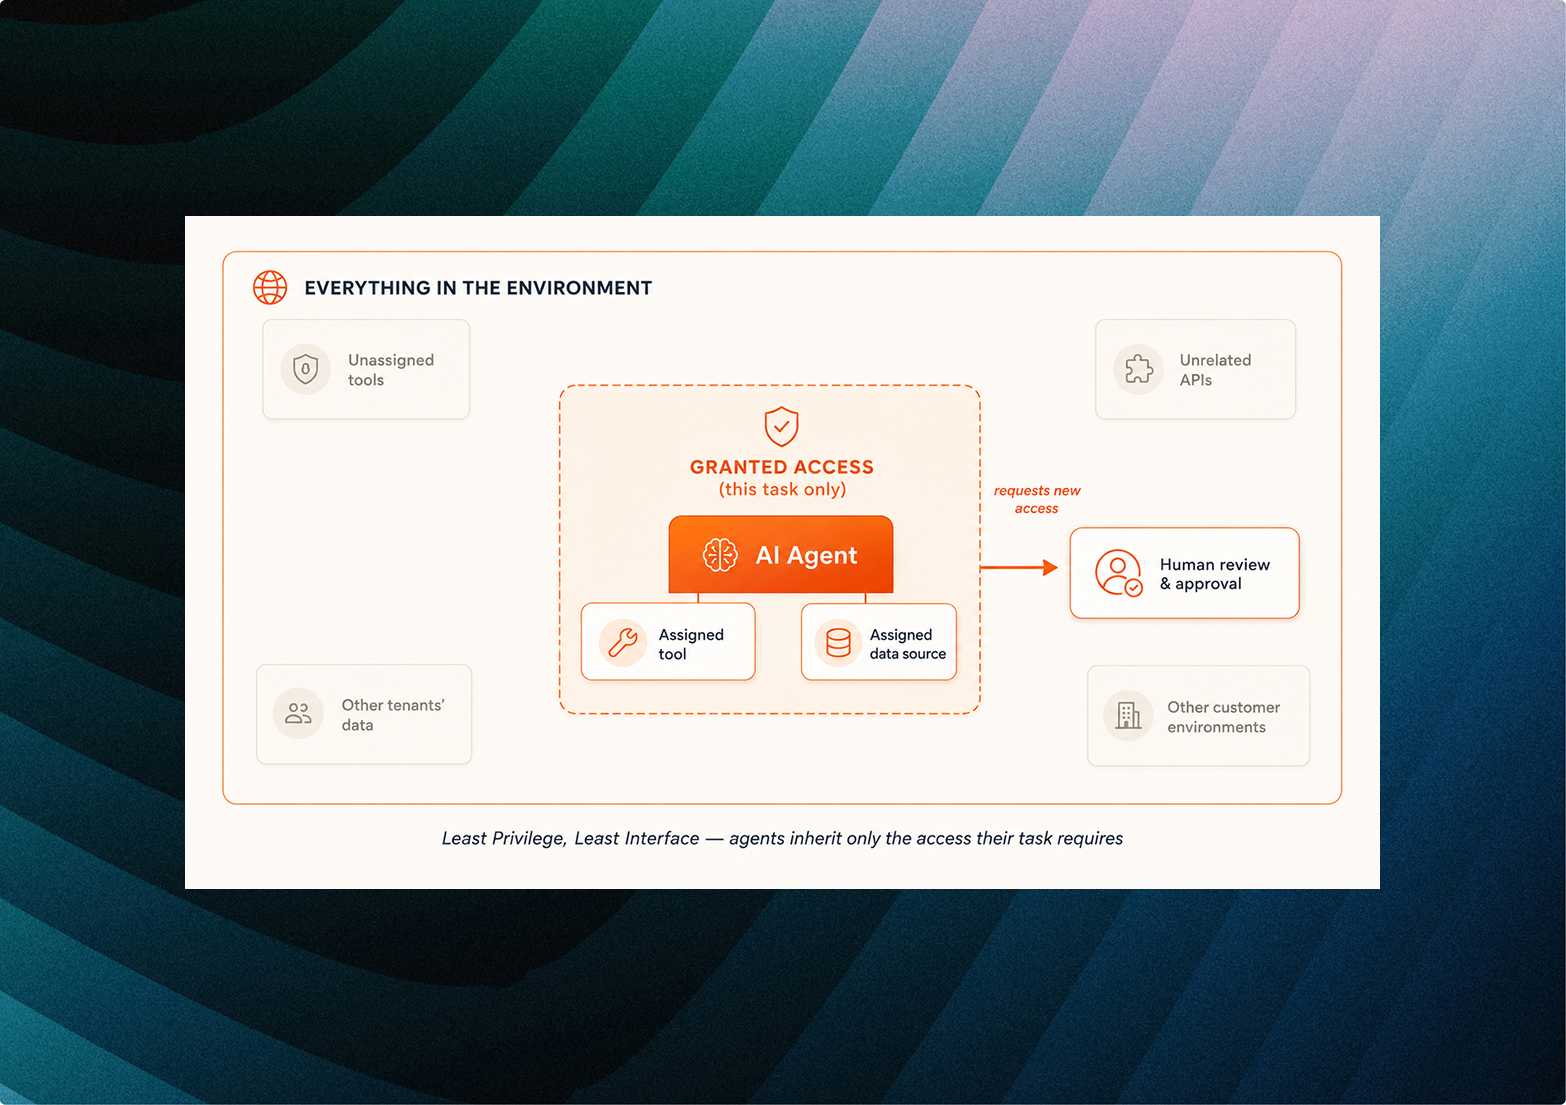
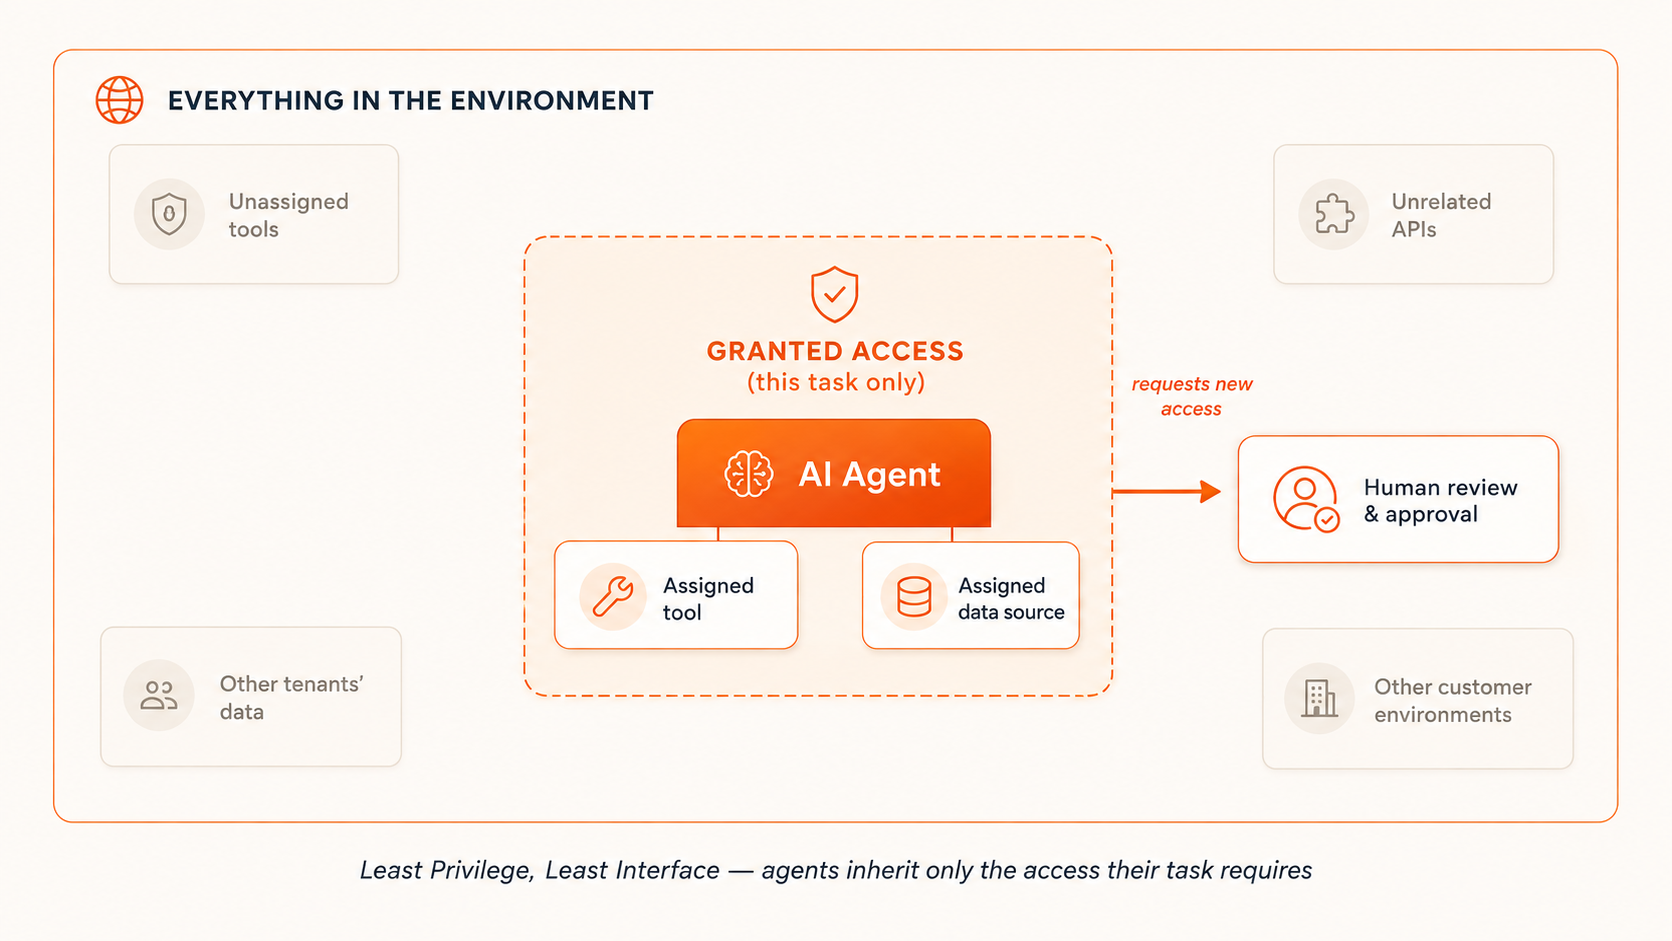
Mindste privilegium, mindste interface
Vi giver aldrig AI frie tøjler i et cybersikkerheds-workflow. Sikkerhedsanalytikere arbejder med begrænset adgang til datakilder, værktøjer og kundemiljøer. AI-agenter bør arve de samme begrænsninger og kun få adgang til det, deres tildelte opgave kræver.
Når en agent har brug for et nyt API, en ny datakilde eller et nyt værktøj, indsender den en anmodning til menneskelig gennemgang og godkendelse, ligesom en ny medarbejder, der anmoder om yderligere adgang. Kapacitet bør aldrig betyde ubegrænset adgang.
Zero Trust
Vi behandler AI-agenter, som vi ville behandle en nyansat analytiker: dygtig, men uprøvet og endnu ikke betroet nøglerne til alt.
Tillid skal vindes gennem en historik, ikke gives som standard. En allowlist-tilgang er udgangspunktet. Nøglerotation er obligatorisk. Omfattende auditering er indbygget i systemet. Anmodninger om bredere tilladelser kræver godkendelse.
Resultatet er et miljø, hvor agenter har den adgang, de har brug for, uden at akkumulere unødvendige privilegier.
Platform-håndhævede forfatninger
Vi giver ikke AI-agenter et sæt regler og håber bare, at de følger dem.
Prompt-baserede instruktioner er ikke en tilstrækkelig sikkerhedsgrænse, fordi den samme model, der læser instruktionerne, også kan behandle ondsindet input, der har til formål at manipulere dens adfærd. Kritiske begrænsninger skal derfor ligge uden for modellen og håndhæves af platformen.
For os inkluderer det principper som:
- Tenant-segregering. Agenter angiver aldrig et tenant-ID i deres anmodninger. Hver agent opererer i et isoleret miljø med adgang til kun én tenant.
- Credential-styring. Agenter ser, vælger eller leverer aldrig legitimationsoplysninger. Platformen indsætter de relevante legitimationsoplysninger, når den kommunikerer med et eksternt system.
- Universel anonymisering. Når følsomme data forlader et tenant-miljø, anonymiserer platformen dem automatisk uden behov for involvering fra agenter.
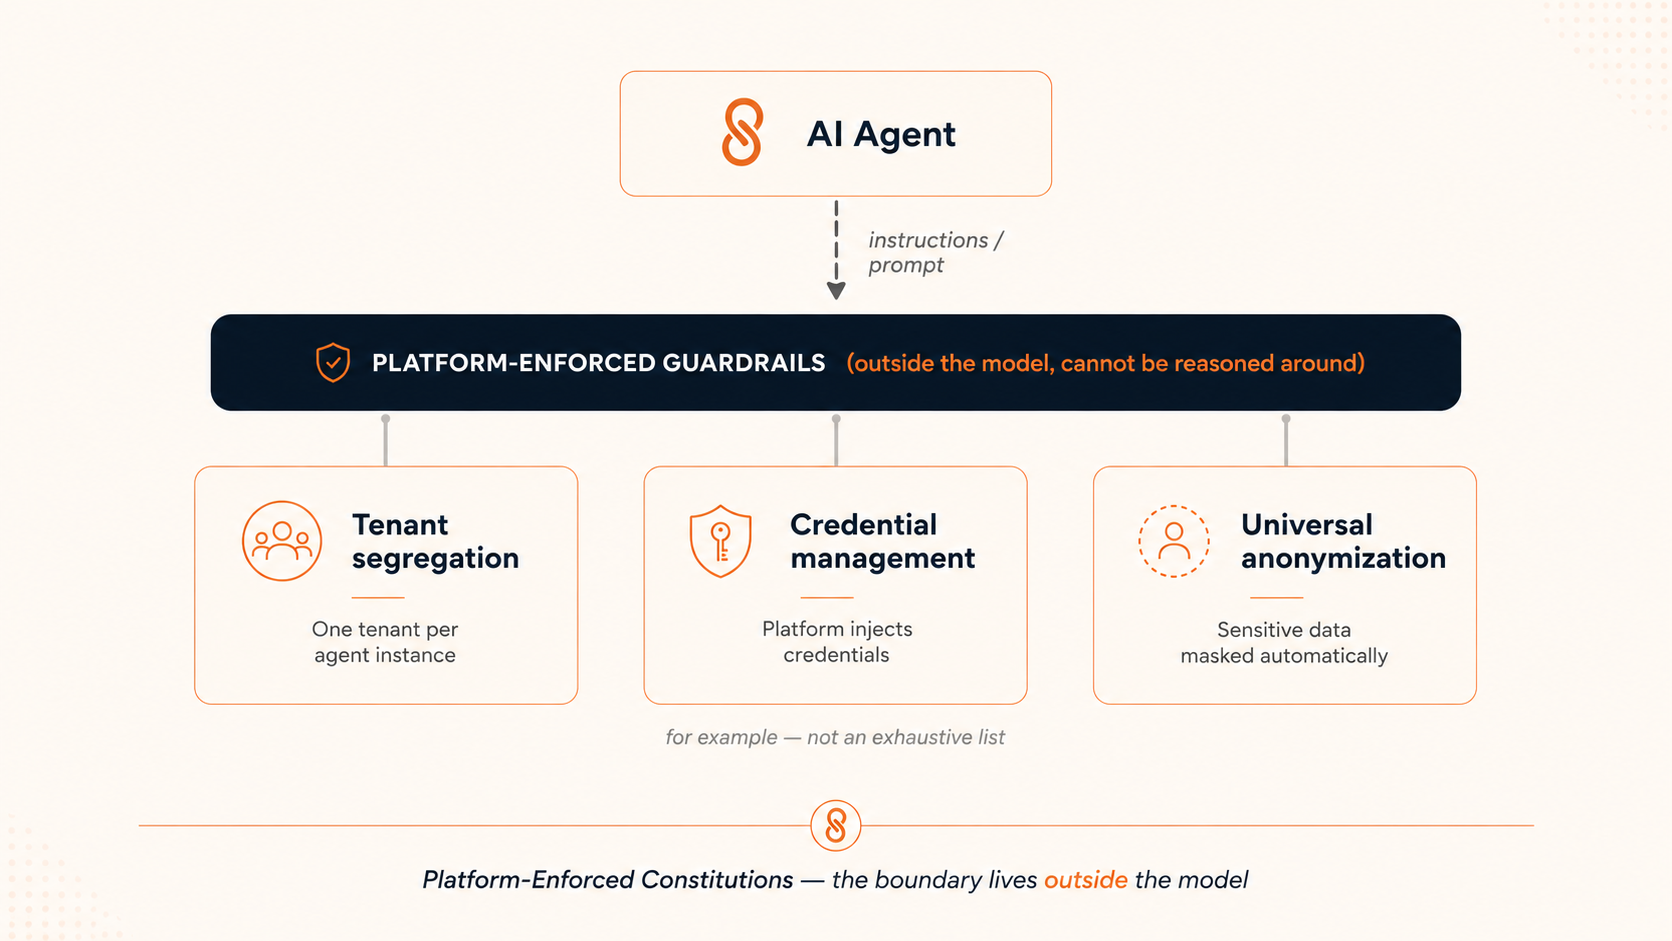
Sikkerhed bør ikke afhænge af, at modellen husker at opføre sig sikkert.
Deterministisk orkestrering og evaluering
Arbejdsgange bør forblive deterministiske, når den underliggende logik allerede er kendt. Vi beder ikke en AI-agent om at beregne noget, der kan håndteres pålideligt af kode. Vi skriver loopet eller bygger funktionen og lader derefter agenten operere inden for den struktur.
AI bør håndtere tvetydighed, fortolkning, undersøgelse og ræsonnement. Kode bør håndtere logik, der allerede er veldefineret. Dette forbedrer pålideligheden og gør samtidig agentens adfærd lettere at teste, evaluere og revidere.
Hukommelse er en angrebsflade
AI-agenter skal lære af fejl, identificere optimeringsmuligheder og anvende etablerede best practices. Men selve hukommelsen introducerer en risiko. Det øjeblik, en agent lærer at afvise et mønster som en falsk positiv, kan være det øjeblik, hvor en trusselsaktør begynder at bruge det samme mønster i et reelt angreb.
Agentens hukommelse kan derfor ikke blive en ukontrolleret samling af historiske konklusioner. Enhver hukommelse kræver defineret herkomst, ejerskab, omfang, konfidens og livscyklushåndtering samt test, validering, udløb og oprydning. Det, en agent lærer, bør styres lige så omhyggeligt som det, den har adgang til.
Kontinuerlig optimering
At definere de rette grænser for AI-agenter er en løbende udfordring. Efterhånden som modeller bliver mere kapable, kan alt for specifikke prompts nogle gange gøre dem mindre effektive. For meget kontrol begrænser deres evne til at ræsonnere i ukendte situationer. For lidt kontrol kan gøre arbejdsgange uforudsigelige eller usikre.
Målet er løbende at finde den rette balance mellem deterministisk og ikke-deterministisk adfærd. Den balance vil ændre sig, efterhånden som modellerne forbedres. En opgave, der kræver stramt styret orkestrering i dag, kan måske trygt uddelegeres til en mere kapabel model i morgen.
Kontinuerlig optimering er derfor en del af arkitekturen, ikke en engangsjustering.
Modelhierarki
En agentbaseret pipeline til cybersikkerhed skal også være omkostningseffektiv. Ellers arver den en af de mest skadelige flaskehalse i det traditionelle SOC: nedprioritering.
Når undersøgelser er dyre, beslutter teams uundgåeligt, hvilke alarmer der fortjener opmærksomhed, og hvilke der kan ignoreres. AI bør reducere den begrænsning, ikke reproducere den. Et modelhierarki tildeler den rette model til den rette opgave baseret på kapacitet, kompleksitet og omkostninger.
Letvægtsmodeller kan håndtere rutinearbejde i store mængder, så hændelser ikke efterlades uundersøgte, blot fordi de ved første øjekast virker ubetydelige. Mere kapable modeller kan træde til, når undersøgelser kræver dybere ræsonnement, orkestrering eller dømmekraft. De mest kapable modeller bør reserveres til det arbejde, der giver størst værdi, herunder forbedring af selve systemet frem for gentagen behandling af rutinesager.
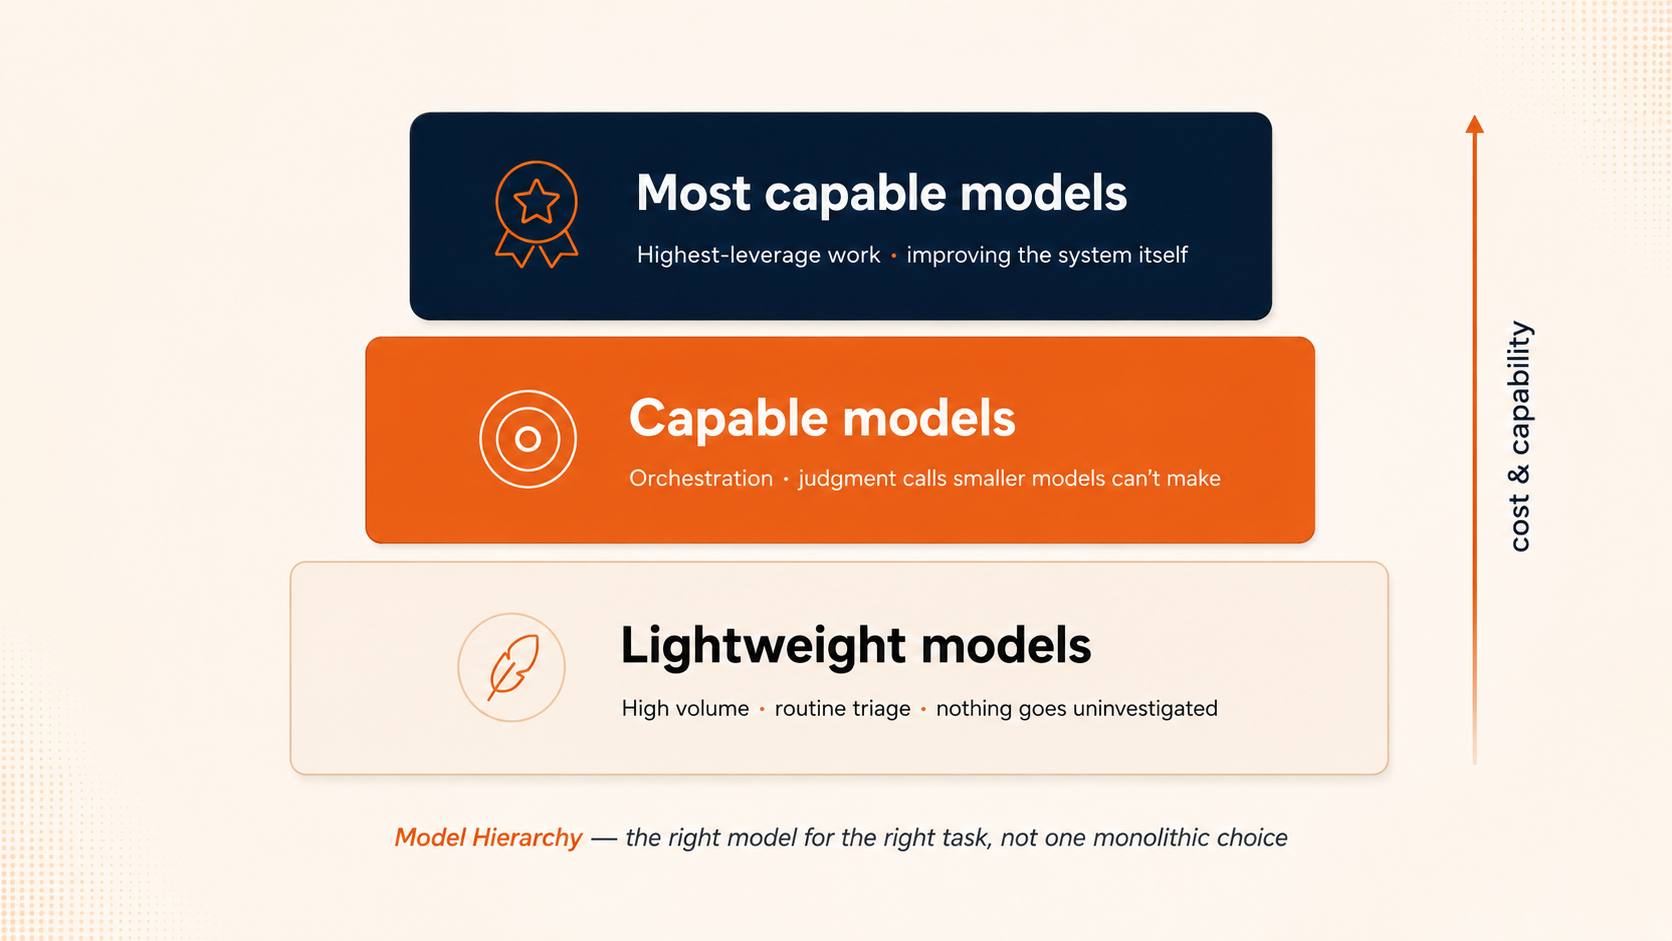
Målet er ikke at bruge den mest kraftfulde model overalt. Det er at gøre avanceret ræsonnement tilgængeligt i hele driften uden at lade omkostninger blive til endnu en form for prioritering.
Mønstre for modelintegration
Et modelhierarki betyder ikke, at hver model fungerer uafhængigt.
Forskellige modeller kan bidrage med forskellige styrker til den samme undersøgelse. Én model kan undersøge, mens en anden evaluerer dens konklusion. Flere modeller kan producere uafhængige vurderinger, som afstemmes, før der handles. I andre tilfælde kan modeller samarbejde om forskellige dele af den samme undersøgelse, hvor en mere kapabel model koordinerer deres arbejde.
Det vigtige spørgsmål er ikke, hvilken enkeltmodel der skal styre arbejdsgangen. Det er, hvordan modeller, deterministiske systemer og menneskelige analytikere kan arbejde sammen om at skabe et bedre resultat, end nogen af komponenterne kunne opnå alene.
Opbygning af sikkerhed omkring AI
AI kan fundamentalt ændre måden, hvorpå managed detection and response fungerer, men kun hvis det omkringliggende system er designet til at understøtte det.
Målet er ikke at klistre en LLM oven på en eksisterende SOC-proces og kalde det AI-drevet MDR. Det handler om at genoverveje, hvordan arbejdet skal fordeles mellem deterministisk software, AI-modeller og menneskelig ekspertise. Det betyder, at man skal begrænse agenter, før man udvider autonomien, håndhæve sikkerhed på platformsniveau, styre hukommelse som infrastruktur, matche modelkapacitet med opgavens økonomi og løbende validere, hvordan systemet opfører sig.
Modellerne vil fortsætte med at blive bedre. Det er arkitekturen omkring dem, der afgør, om disse forbedringer udmønter sig i en sikkerhedsdrift, der er mere sikker, mere skalerbar og mere effektiv.