
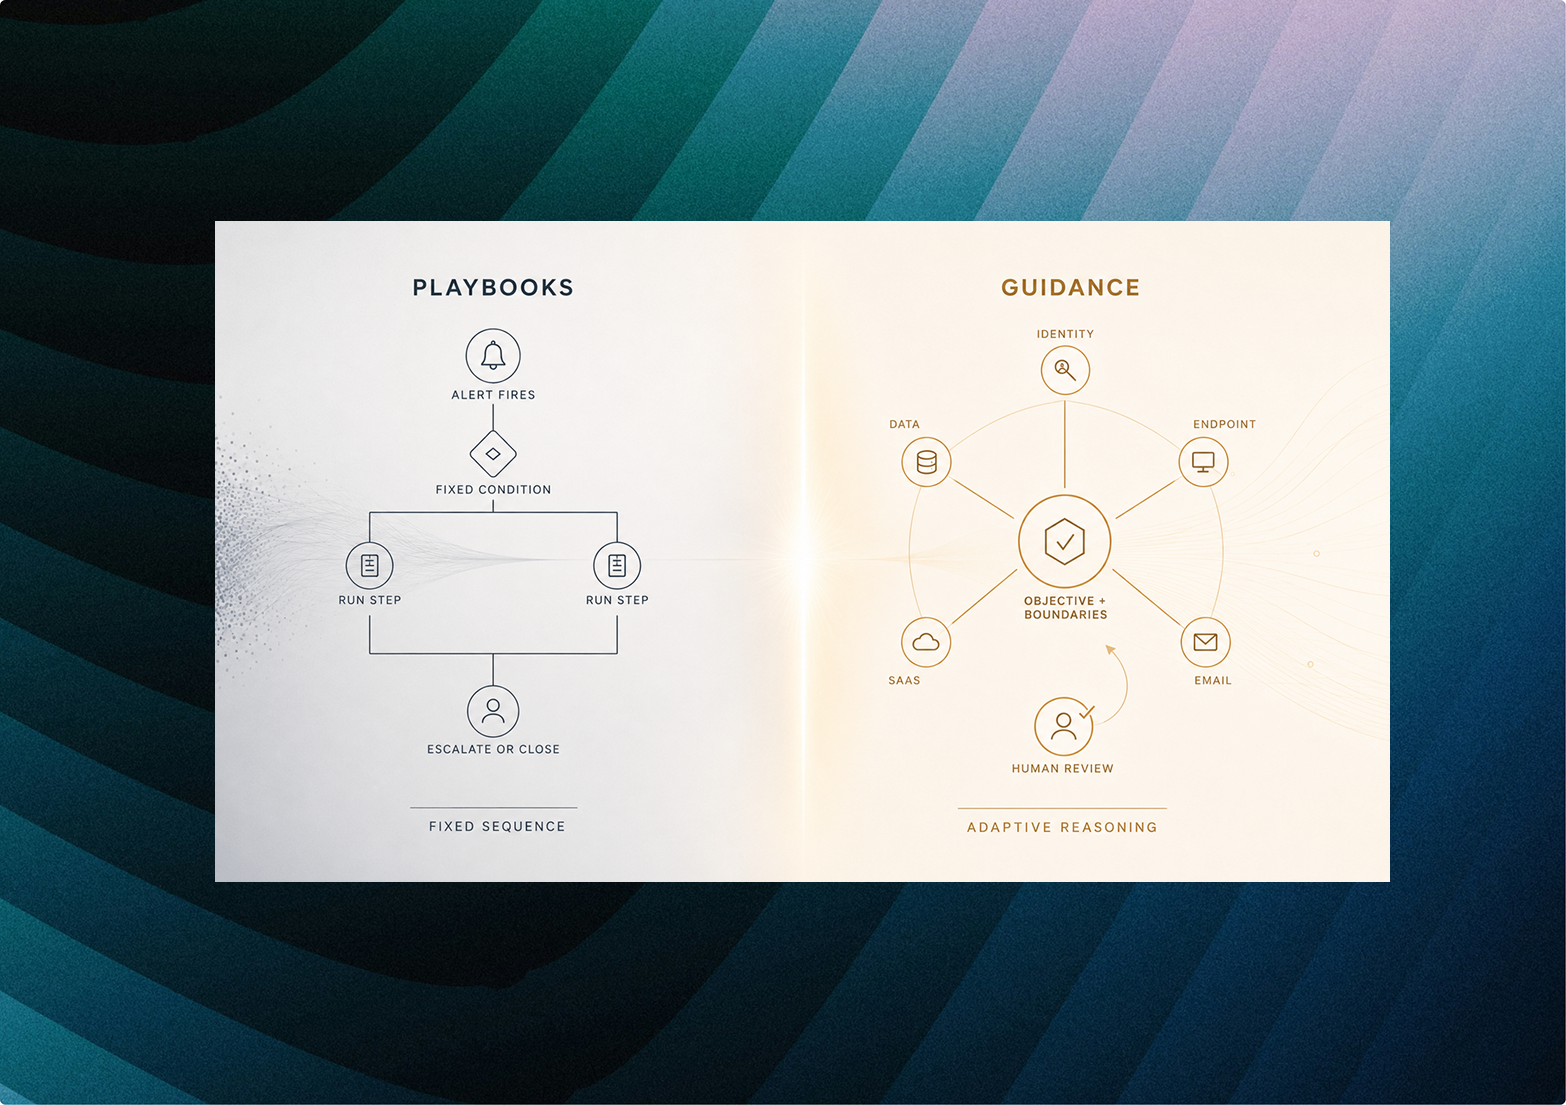
Sikkerhedsautomatisering blev bygget op omkring playbooks af en god grund: Analytikere glemmer trin under pres, og traditionelle værktøjer kunne kun udføre det, de eksplicit fik besked på. Derfor dokumenterede organisationer hver handling og eskaleringsvej som en struktureret sekvens, f.eks. hvis betingelse A er opfyldt, tjek B; hvis beviser overstiger tærskel C, gør D. Det reducerede variation og blev fundamentet for SOAR og det meste tidlige SOC-automatisering.
Et AI-native SOC står over for en anden problemstilling. LLM'er besidder dyb teknisk viden og kan ræsonnere sig gennem situationer, som ingen playbook-forfatter havde forudset. At tvinge dem gennem stive runbooks gør dem blot til en dyr version af traditionel automatisering. Spørgsmålet er ikke, hvordan man skriver en bedre playbook, men hvordan man definerer arbejdet for et system, der kan ræsonnere. Svaret er ganske enkelt vejledning.
Hvorfor playbooks var nødvendige
Playbooks løste to problemer: menneskelig inkonsistens, da analytikere håndterer den samme advarsel forskelligt afhængigt af erfaring, og maskinel ufleksibilitet, da automatisering ikke kunne fortolke hensigt og havde brug for, at hver gren blev stavet ud. En phishing-playbook kan fortælle systemet, at det skal udtrække URL'er, tjekke domæneomdømme og sætte e-mailen i karantæne, hvis visse indikatorer optræder. Dette er kun nyttigt, når systemet ikke selv kan vurdere, hvad der er vigtigt. En LLM kan i stedet forstå målet og tilpasse sig, efterhånden som resultaterne dukker op, selvom en stiv playbook stadig begrænser den til en logik, der kun afspejler, hvad forfatterne vidste på det tidspunkt.
Overvej en identitetsadvarsel for et login fra en ny geografisk placering. En traditionel playbook tjekker IP-omdømme, umulig rejse og MFA-status, og lukker derefter advarslen, hvis disse er i orden. Et AI-system kan i stedet bemærke, at den samme bruger for nylig modtog en mistænkelig OAuth-samtykkeanmodning og tilgik en ukendt SaaS-app. Intet enkelt signal overskrider playbookens tærskel, men tilsammen antyder de et kompromis: en sammenhæng, som AI'en aldrig ville drage, hvis den var begrænset til login-playbooken. Playbooken gør det ikke mere sikkert, blot mere blindt for den kontekst, den allerede har.
Vejledning definerer målet
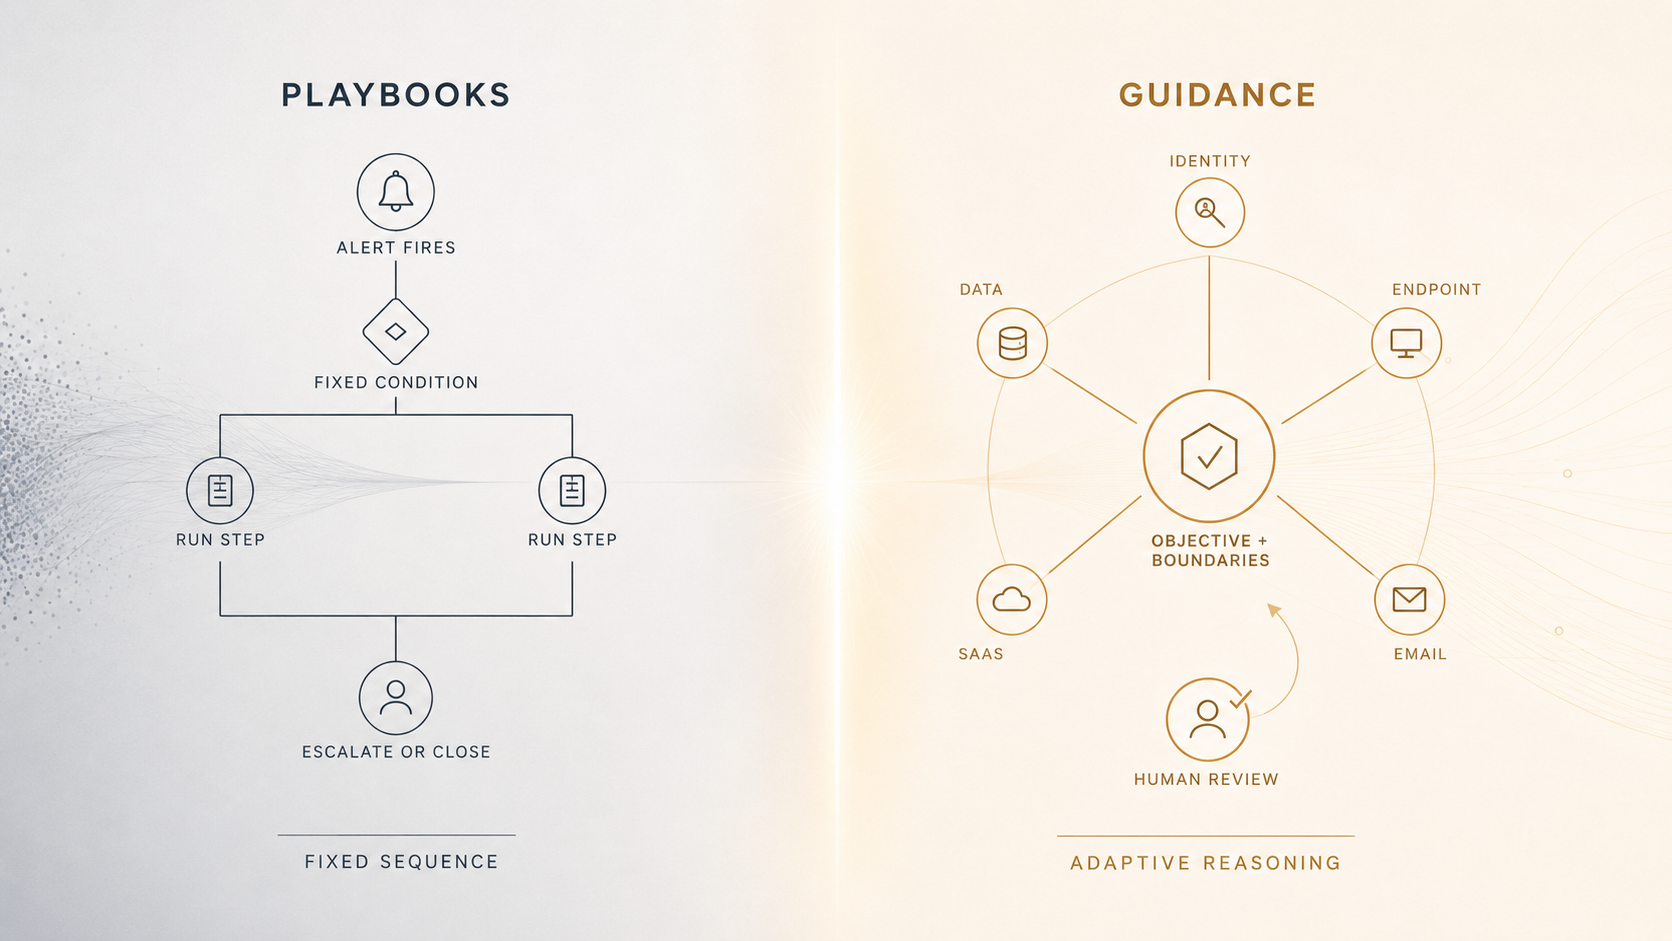
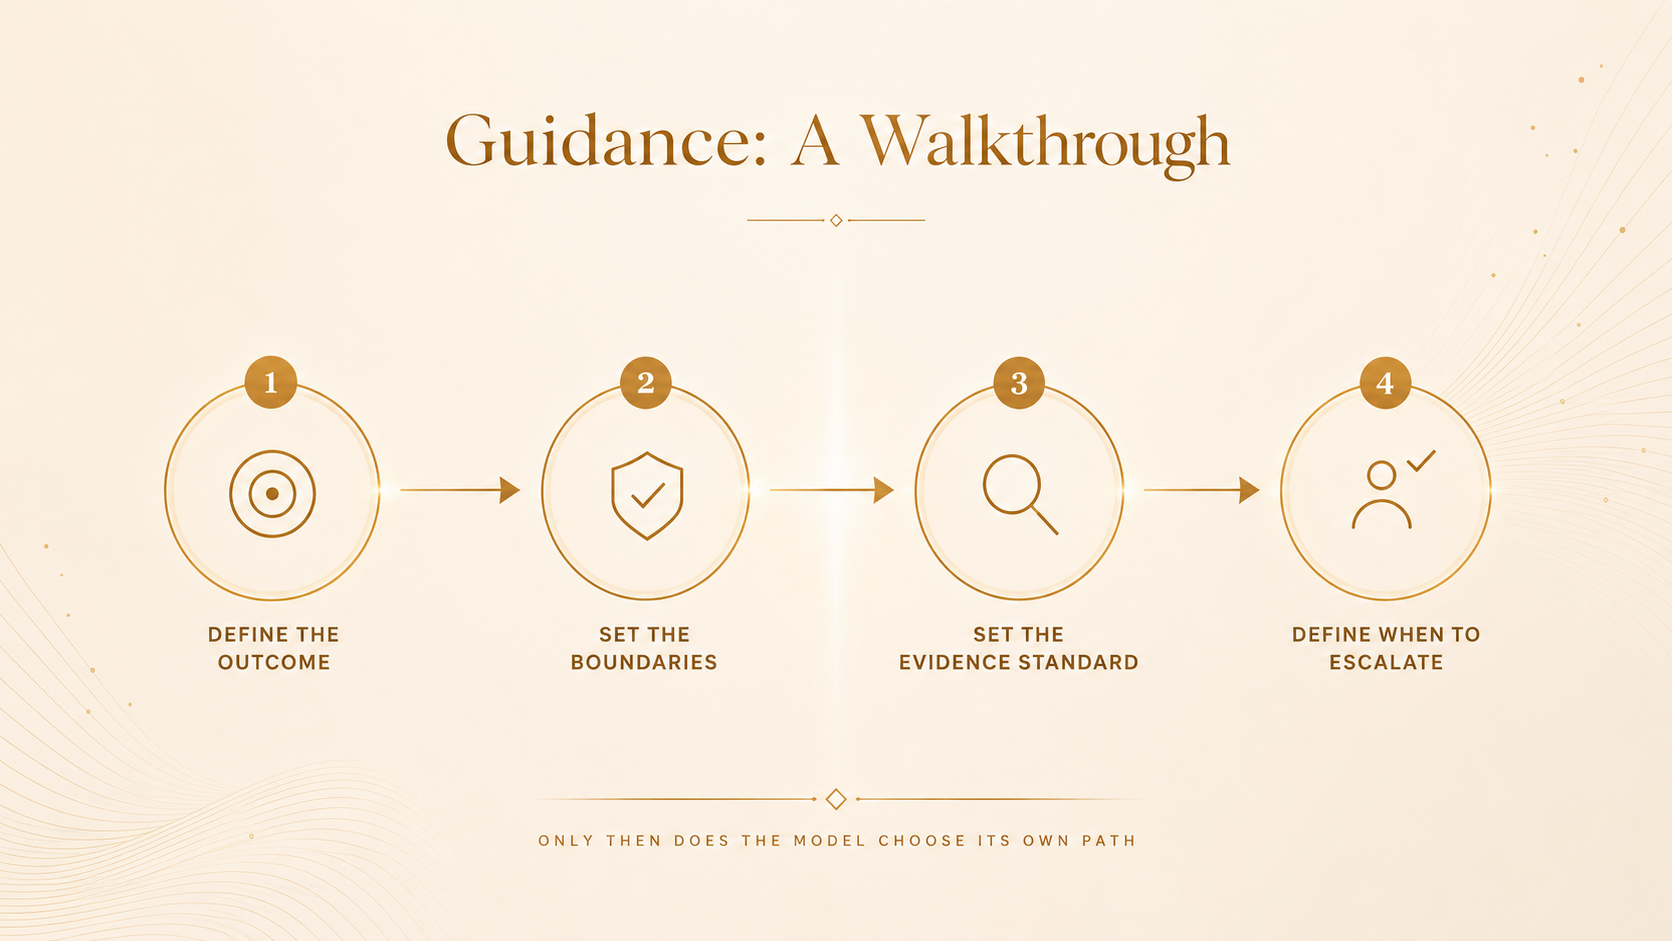
Vejledning er ikke fravær af proces, men en anden måde at definere den på. I stedet for at foreskrive hvert trin, angiver den resultatet, rammerne, beviskravene og hvornår menneskelig gennemgang er påkrævet. For en identitetsundersøgelse kan vejledningen lyde:
- Afgør, om aktiviteten er i overensstemmelse med brugerens normale adfærd og godkendte forretningsaktivitet.
- Inddrag beviser fra autentificering, endpoint, e-mail, SaaS og dataadgang.
- Deaktiver ikke en konto udelukkende baseret på geolokation.
- Eskalér før enhver handling, der kan afbryde ledelsesmæssige eller produktionsmæssige operationer.
- Registrer de beviser, der understøtter og modsiger konklusionen.
Dette definerer, hvad en god undersøgelse skal opnå, uden at tvinge en fast rækkefølge igennem. Modellen kan selv prioritere sine skridt, anmode om yderligere beviser og justere kursen, efterhånden som fakta ændrer sig.
Grænser betyder mere end instruktioner
Det vigtigste proceselement i et AI-baseret SOC er måske en klar definition af, hvad systemet ikke må gøre. En kapabel model kan generere mange mulige handlinger; risikoen er at lade den handle uden tilstrækkelige begrænsninger. Ved undersøgelse af malware kan den få lov til at søge i telemetri og udarbejde et resumé, men den må ikke isolere en produktionsserver uden godkendelse, slette filer eller lukke en hændelse, mens kritiske beviser mangler. Disse grænser holder længere end en playbook, fordi de forbliver relevante, selv når angrebsmønstrene ændrer sig.
Retningslinjer bør definere beviskvalitet
AI-baserede undersøgelser kræver stadig standarder. En model bør ikke belønnes for et selvsikkert svar alene; den skal også vise, hvordan beviserne understøtter det. Ved en mistanke om datalæk kan retningslinjerne kræve identifikation af den involverede bruger, de berørte aktiver, dataenes følsomhed og om aktiviteten var autoriseret. Det forhindrer modellen i at behandle en plausibel fortælling som en bekræftet hændelse og giver korrekturlæsere et ensartet grundlag for at evaluere arbejdet.
Retningslinjer muliggør adaptive undersøgelser
AI-baserede undersøgelser kræver stadig standarder. En model bør ikke belønnes for et selvsikkert svar alene; den skal også vise, hvordan beviserne understøtter det. Ved en mistanke om datalæk kan retningslinjerne kræve identifikation af den involverede bruger, de berørte aktiver, dataenes følsomhed og om aktiviteten var autoriseret. Det forhindrer modellen i at behandle en plausibel fortælling som en bekræftet hændelse og giver korrekturlæsere et ensartet grundlag for at evaluere arbejdet.
Playbooks spiller stadig en rolle
Playbooks forsvinder ikke. De er stadig nyttige til deterministiske handlinger, hvor konsistens betyder mere end ræsonnement, såsom indsamling af en forensisk pakke eller blokering af et bekræftet ondsindet hash. Det, der ændrer sig, er deres placering i driftsmodellen: De bør styre gentagelig udførelse, ikke hele ræsonnementsprocessen. Retningslinjer styrer undersøgelse og dømmekraft; playbooks styrer godkendte mekaniske handlinger. Det er i bund og grund et skift fra procedure til hensigt. Et traditionelt SOC fortæller systemet præcis, hvilke skridt der skal følges; et AI-baseret SOC definerer resultatet, beviskravene, grænserne og de punkter, hvor ansvaret vender tilbage til et menneske. Det er ikke mindre kontrol, men en mere passende form for kontrol for et system, der kan ræsonnere.
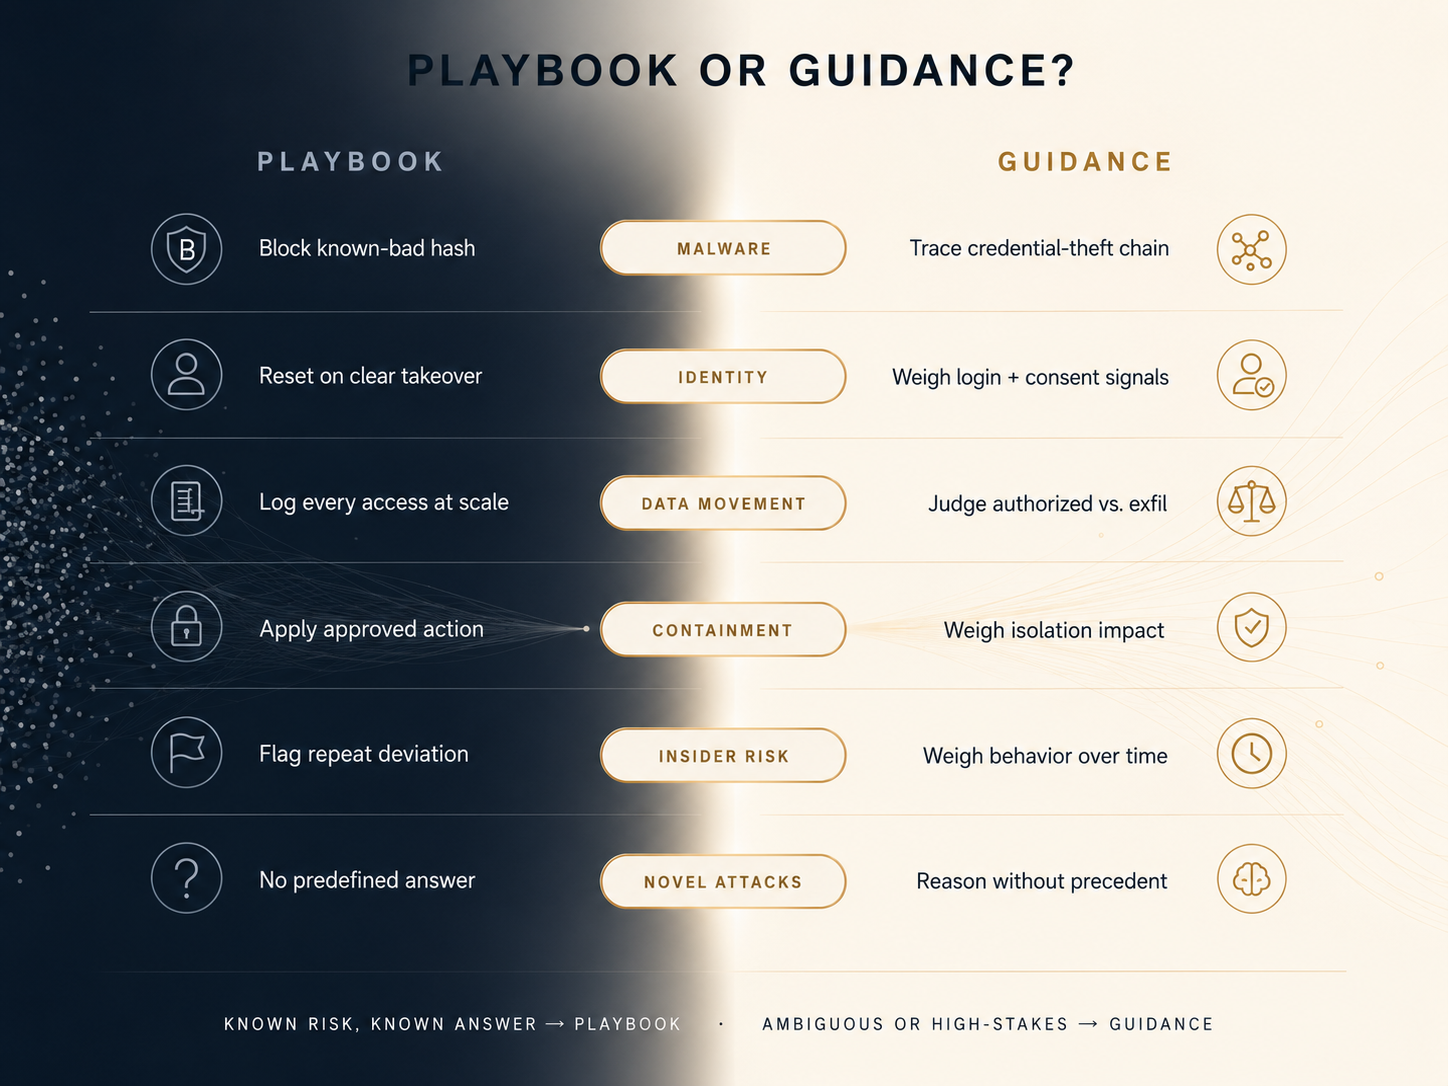
Organisationer, der gør dette rigtigt, vil ikke bare automatisere gamle runbooks hurtigere. De vil opbygge processer, der lader AI undersøge bredt, tilpasse sig nye beviser og operere sikkert inden for klart definerede rammer.