
Token-økonomi blev et seriøst samtaleemne i det øjeblik, branchen indså, at vi havde fået en urimelig generøs rabat fra AI-leverandører. Nu hvor gratisversioner skrumper, og forbrugsgrænser dukker op overalt, er teams begyndt at rationere tokens, ligesom de engang rationerede analytikertimer.
Den instinktive reaktion er forståelig. Det er også sådan, krisen med SOC-bemanding oprindeligt opstod. Skalering baseret på ansættelser var ikke en fejl; det var den eneste måde at drive en SOC på, før AI kunne overtage det egentlige triageringsarbejde. Men det låste alle teams fast under et loft, som man stadig betaler prisen for i dag, og ved at rationere AI-kapacitet på samme måde risikerer man at genskabe det.
Loftet som enhver SOC allerede har ramt
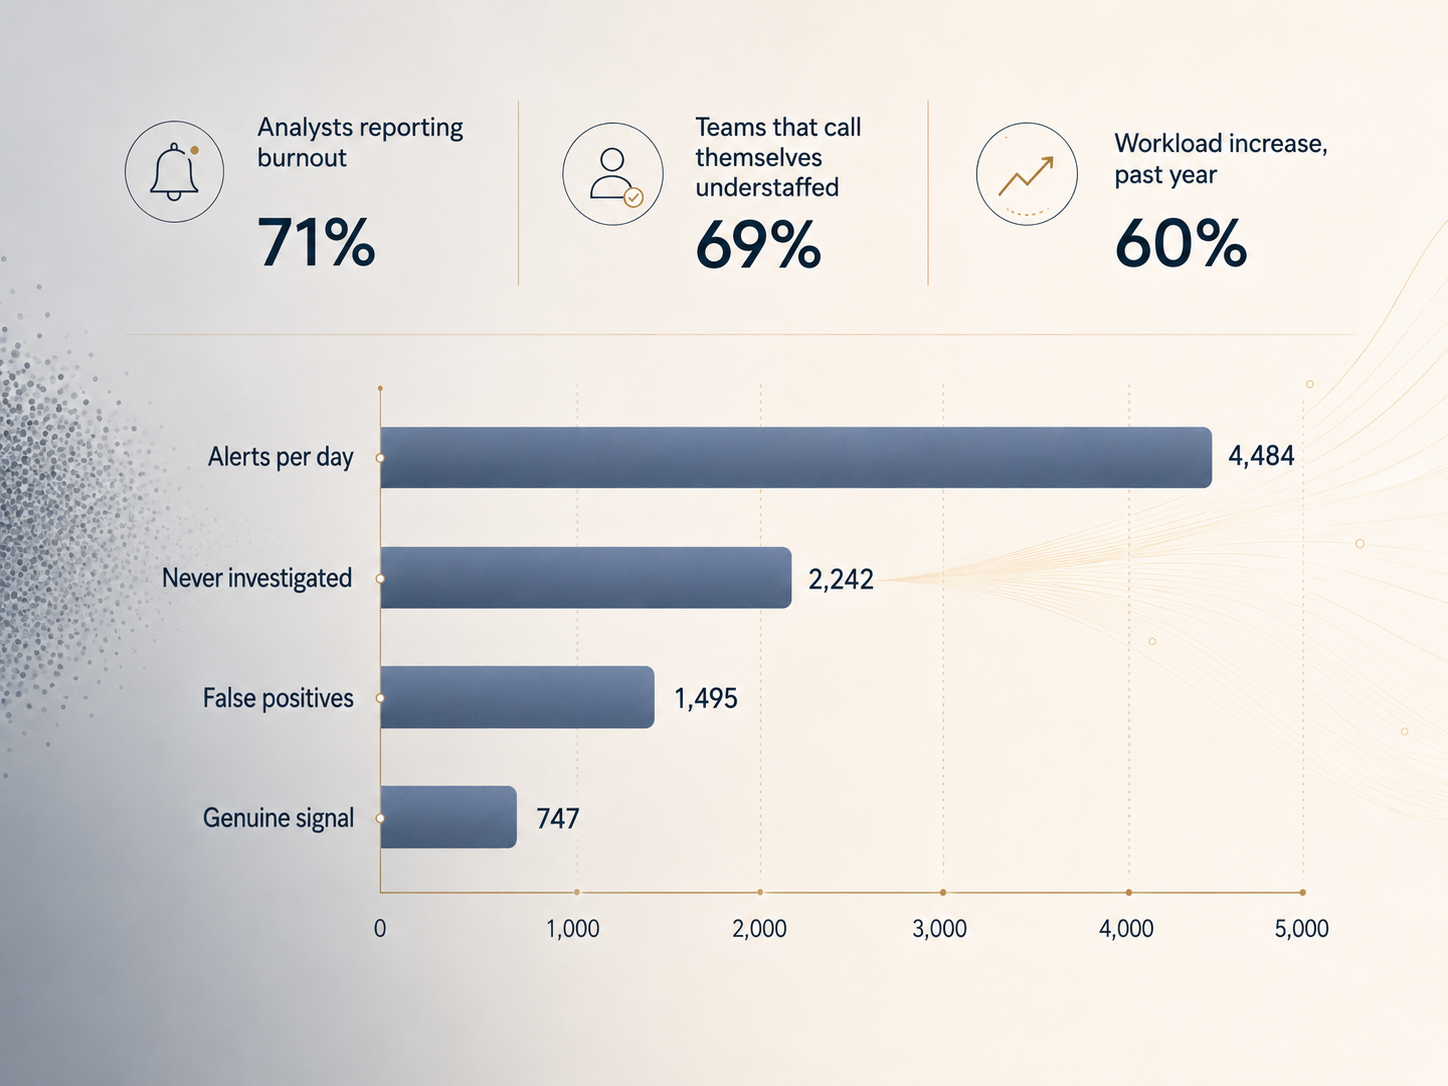
Traditionelle SOC'er skalerer ved at ansætte, og ansættelser har et hårdt loft: Medarbejdere koster penge, så hvert team begrænser kapaciteten til et niveau under den faktiske mængde af alarmer, de står overfor. Den gennemsnitlige organisation genererer nu cirka 4.484 alarmer om dagen, og omkring halvdelen bliver slet ikke undersøgt (Netenrich, 2025).
Ledelsesomkostninger er et endnu hårdere loft end selve ansættelsesbudgettet. En SOC-leder kan kun effektivt styre et vist antal analytikere, og når et team vokser ud over det spænd, tilføjer organisationsdiagrammet endnu et lag af ledere, derefter ledere af ledere, og koordineringsomkostninger begynder at æde de kapacitetsgevinster, som de ekstra medarbejdere skulle have givet. Selv med et ubegrænset ansættelsesbudget og verdens største kontor bliver ledelsesomkostninger flaskehalsen længe før budgettet gør.
Det gab er ikke gratis. Det viser sig som udbrændthed: 71 % af SOC-analytikere rapporterer om udbrændthed, og 64 % siger, at de sandsynligvis vil skifte job inden for et år (Tines, "Voice of the SOC Analyst"). 42 % af SOC-ledere rapporterer, at medarbejdernes anciennitet aktivt falder (Netenrich, 2025). Kapacitetsbegrænsninger skabte ikke bare et dækningsgab, de byggede en maskine for medarbejderudskiftning. Nedprioritering medfører også sin egen risiko: Studier af SOC-alarmkøer har vist, at så få som 1 ud af 100 undersøgte alarmer viser sig at være en reel trussel, hvilket betyder, at generel nedprioritering ikke kan skelne den ene rigtige alarm fra de 99, der ikke er det (Alahmadi et al., USENIX Security). Nedprioritering er ikke neutralt, det er en angrebsflade.
At gentage den samme fejl med AI
Når man skifter til en AI-native SOC, er det første spørgsmål, folk stiller, stadig et spørgsmål om kapacitet, bare med tokens i stedet for medarbejdere: Hvis vi sender 10 % af hændelserne til modellen, hvad er så regningen? Skal vi skære det ned til 5 %? Prissætningen på frontlinjen gør den instinktive reaktion rationel isoleret set, f.eks. koster Claude Opus 4.6 $5/$25 pr. million input/output-tokens, og top-ræsonnementsmodeller andre steder på markedet koster helt op til $30 pr. million input-tokens (CloudZero, LLM API Pricing Comparison 2026).

Men hvis man optimerer ud fra det tal, genskaber man præcis det loft, som SOC'en lige er sluppet fri af. Hvis AI-kapaciteten bliver rationeret på samme måde som analytikertimer, bliver hændelser prioriteret fra for at passe ind i et budget i stedet for at blive undersøgt, fordi de er vigtige.
To forskellige udgangsspørgsmål
"Hvor mange tokens har vi råd til" og "hvordan holder vi modellen kørende døgnet rundt på alle svage signaler" skaber to forskellige SOC'er. Den første behandler AI som en dyr post på lønbudgettet til analytikere. Den anden behandler det som infrastruktur, hvilket er noget, der stilles til rådighed til konstant brug, ikke som en knap ressource, der skal måles og vejes.
Det skift fungerer kun, hvis omkostninger ikke er den primære begrænsning, designet drejer sig om, hvilket betyder, at det underliggende modellag ikke må ligne et enkelt frontier API-kald pr. hændelse.
Hvorfor pipelinen skal være i flere niveauer
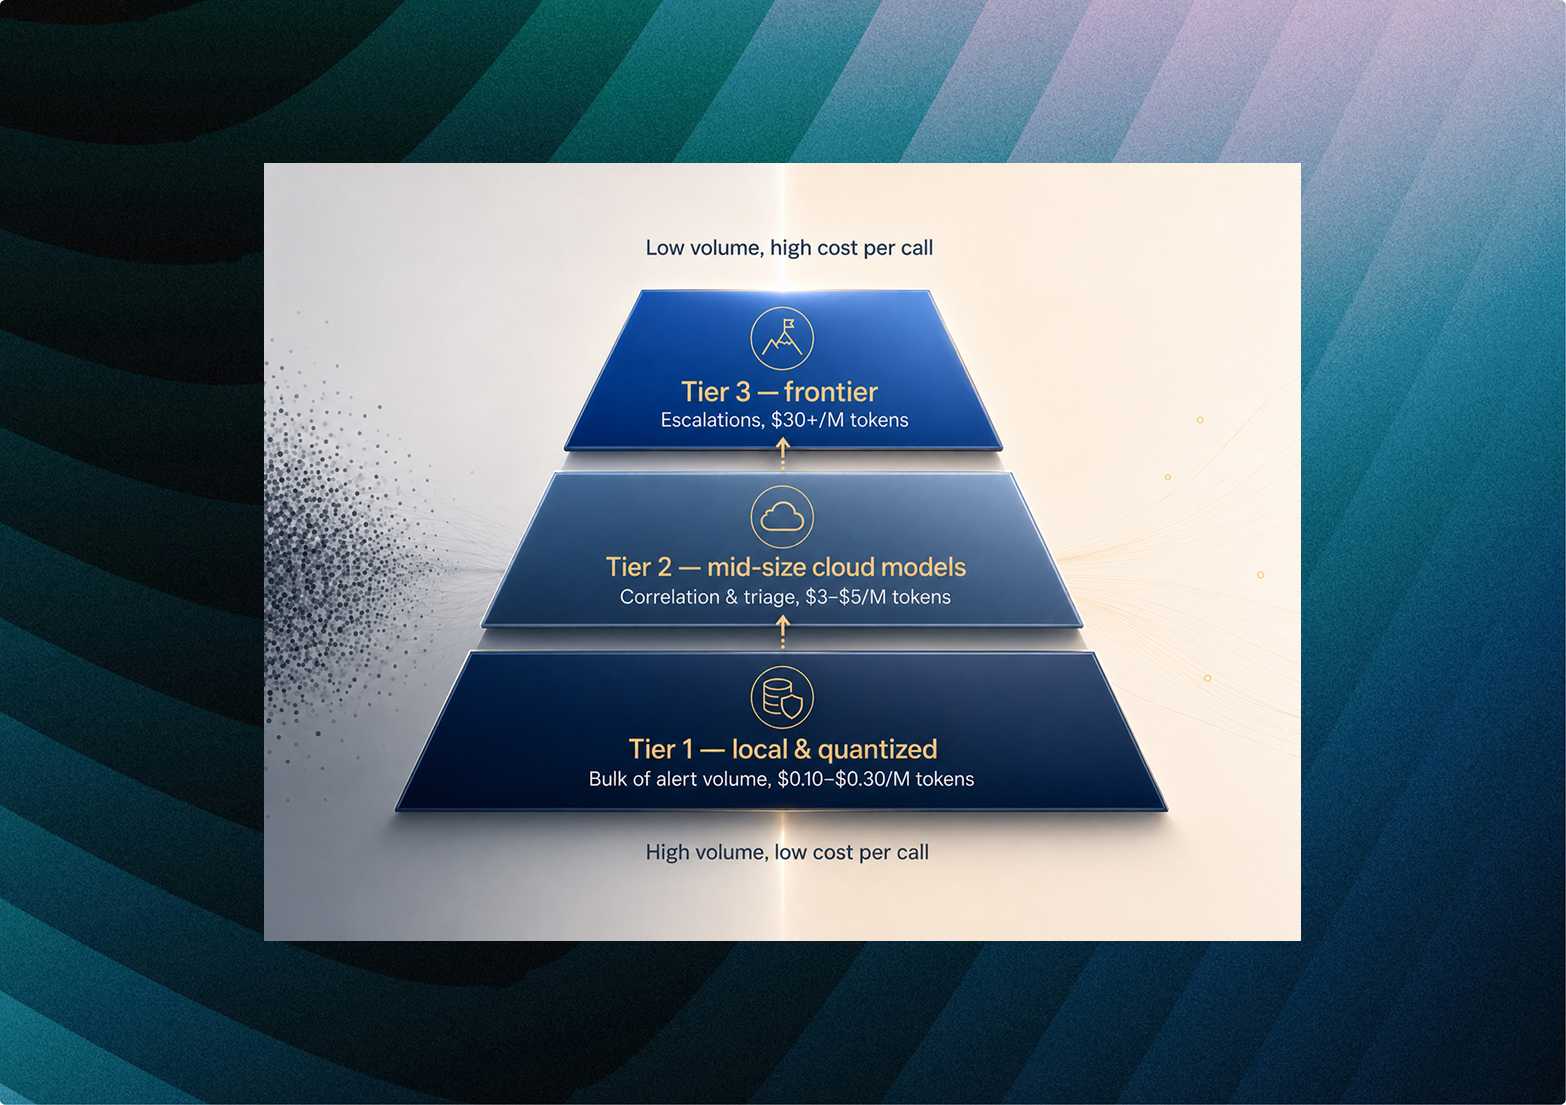
Prissætningen på modelmarkedet spænder nu over en bred vifte, fra $0,20 pr. million input-tokens for standardmodeller som GPT-5.6 Luna op til $30 for de øverste ræsonneringsniveauer (CloudZero, LLM API-prissammenligning 2026). Det spænd er hele pointen: En pipeline i flere niveauer sender rutinemæssig triage til små, billige og nogle gange lokalt hostede modeller, og reserverer frontier-ræsonnering til de få tilfælde, der rent faktisk har brug for det.
Det, der gør det billige niveau levedygtigt i stor skala, er at køre disse modeller på lokale GPU-ressourcer i stedet for at betale frontier API-takster pr. token for rutinemæssig triage. En model, der hostes på egen eller dedikeret GPU-hardware, koster stort set det samme, uanset om den håndterer ti kald om dagen eller ti millioner, hvilket kobler bunden af pipelinen helt fra token-baseret prissætning. Fast kapacitet med lave marginalomkostninger i bunden af pipelinen er det, der gør, at toppen kan reserveres til reelle eskaleringer.
Hvad AI ikke bliver træt af
Hvis man driver en traditionel SOC efter princippet om at "holde enhver analytiker maksimalt beskæftiget hele tiden", er det første, der går i stykker, fastholdelsesraten. Intet team overlever den driftsmodel. Det er præcis derfor, skiftet er vigtigt: AI bliver ikke træt, siger ikke op og behøver ikke at få udskiftet en femtedel af sin arbejdsstyrke hvert år. Den har bare brug for strøm, køling og GPU'er – rigtig mange GPU'er.
Den forskel er argumentet for at vende pipelinen om. Når ledig modelkapacitet er næsten gratis, forsvinder den begrænsning, der i første omgang tvang til nedprioritering (et fast antal trætte mennesker).
Hvor omkostningerne retteligt hører hjemme
Intet af dette gør token-omkostninger irrelevante. Det flytter dem bare til det rigtige sted i pipelinen: et spørgsmål, man stiller ved de få tilfælde, der eskalerer til frontier-ræsonnering, ikke en barriere, der lægges på enhver indkommende advarsel. Effektive modeller som DeepSeek V4 Flash kører allerede til $0,14/$0,28 pr. million input/output-tokens (CloudZero, LLM API-prissammenligning 2026), hvilket er billigt nok til, at "skal vi overhovedet kigge på det her" holder op med at være et reelt budgetspørgsmål.

SOC-branchen brugte et årti på at opbygge en model, hvor hver analytiker ramte et hårdt kapacitetsloft, og udbrændthed var prisen for det loft. At gentage det samme design med tokens flytter bare placeringen af loftet. En pipeline i flere niveauer er billig og lokal i bunden og har frontier-ræsonnering i toppen. Det er det, der rent faktisk lader begrænsningen forsvinde i stedet for blot at skifte valuta.
I næste indlæg vil vi dykke ned i, hvordan vi bygger den pipeline i flere niveauer, og hvordan vi måler, om den rent faktisk virker.